
O Kolibri-1 é um modelo de IA de texto da Aleph Alpha, empresa de Heidelberg, Alemanha. Você pode baixar os pesos no Hugging Face e rodá-lo em infraestrutura própria. Assim, por exemplo, um escritório pode analisar documentos sem enviá-los a um serviço externo. Isso não garante conformidade com a LGPD por si só: acesso, retenção e segurança continuam sendo responsabilidade da empresa.
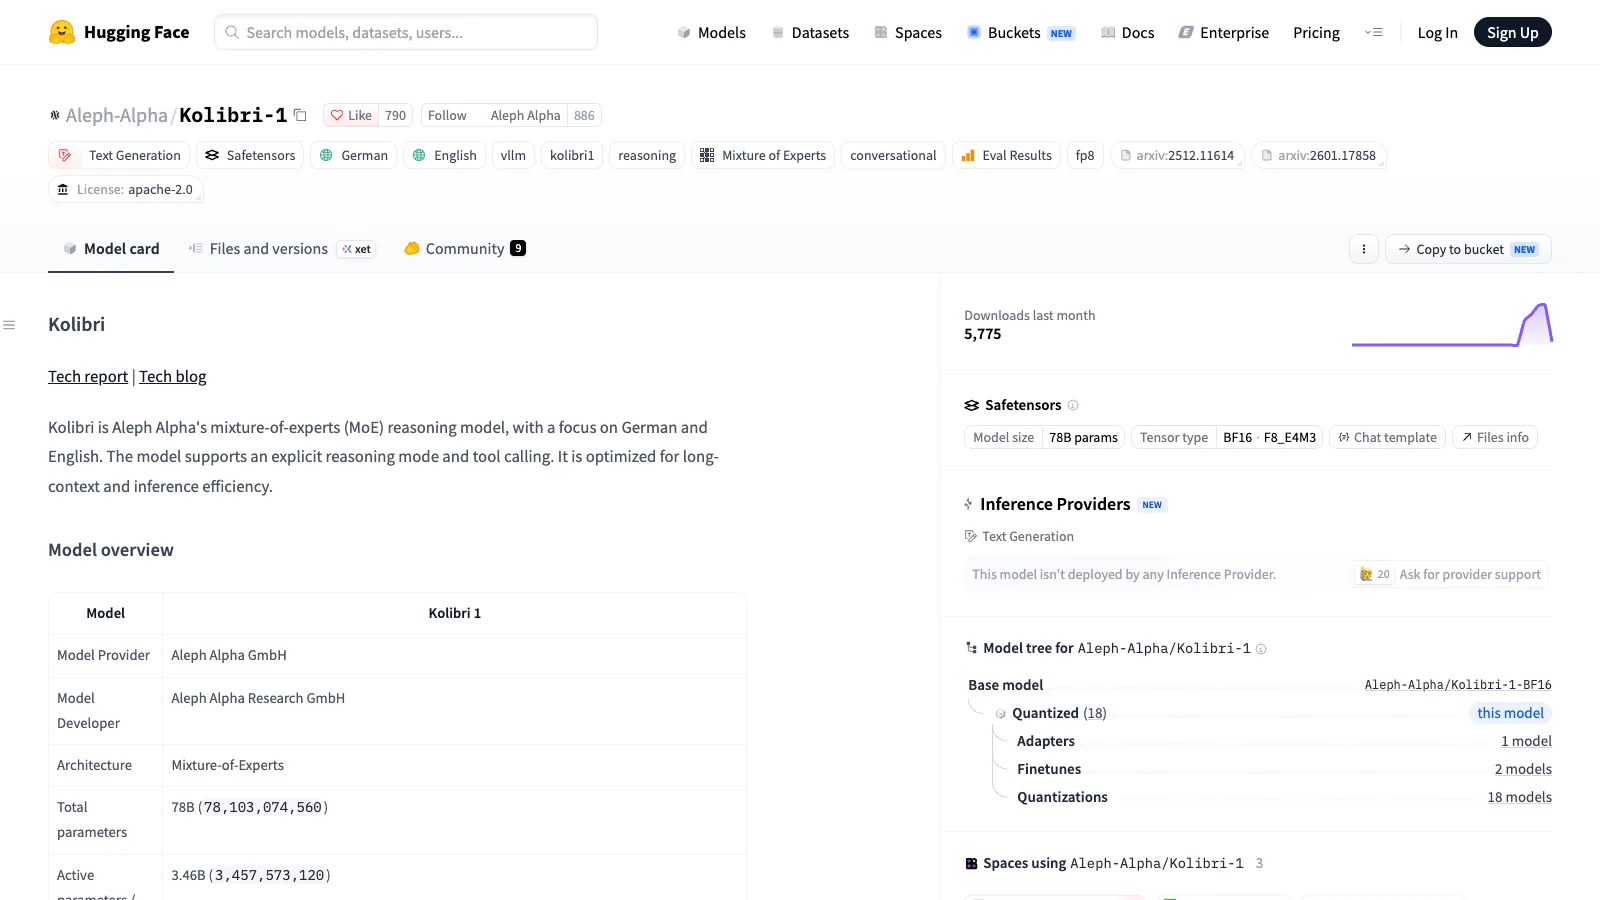
Pesos abertos sob Apache 2.0 permitem uso comercial e adaptação, inclusive em um produto. A licença dos pesos e arquivos de configuração não abre o código de treinamento. O modelo foi lançado em 03/10/2026. Ele entende inglês e alemão, não é um modelo para português, e só trabalha com texto.
Imagine um hospital com 384 especialistas por andar: para cada palavra, 6 são chamados, além de 1 especialista fixo. É a mistura de especialistas (MoE): em cada uma das 50 camadas, para cada token, só parte do modelo calcula a resposta. São 78,1 bilhões de parâmetros no total, 3,46 bilhões ativos por token. Mas os pesos inteiros ainda precisam caber na memória.
Você tem a máquina?
| Máquina | Caminho em 08/10/2026 |
|---|---|
| Servidor GPU | FP8 oficial: aproximadamente 78 GB de pesos; mínimo 1 H200/B200/B300 ou 2 A100 de 80 GB / H100 SXM5. |
| Mac Apple Silicon 64 GB | Conversão comunitária MLX 4-bit, cerca de 41 GiB em disco; autor relata pico de 44 a 48 GB conforme o prompt. Não é versão oficial. |
| Mac 48 GB ou 36 GB | Conversões comunitárias de 3-bit ou 2-bit respectivamente; maior perda de qualidade. Não são o procedimento deste guia. |
| Notebook comum / 16 a 32 GB | Não conte com execução local útil deste modelo. Use outro modelo menor ou um servidor. |
Este guia não foi executado num Mac de 64 GB: nossa máquina tem 16 GB. Não há capturas de instalação, resposta ou Monitor de Atividade, nem números de velocidade medidos por nós. Os próximos comandos vêm da documentação do conversor comunitário e precisam de validação manual no hardware indicado.
Instale no Mac de 64 GB (passo da documentação, não testado por nós)
Em um Mac Apple Silicon com 64 GB de memória unificada, espaço livre superior ao download de 41 GiB e Python 3, crie um ambiente isolado:
python3 -m venv kolibri-env && source kolibri-env/bin/activateInstale as dependências. Não há versão de mlx-lm validada por nós; este comando instala a versão disponível quando você rodar. Anote-a antes do teste:
python -m pip install -U mlx-lm huggingface_hubpython -m pip show mlx-lmBaixe a conversão 4-bit de velaia, incluindo seu run.py e kolibri1.py. Confira o código comunitário antes de executar; não é publicação oficial da Aleph Alpha:
hf download velaia/Kolibri-1-MLX-4bit --local-dir Kolibri-1-MLX-4bitNão use o mlx_lm.generate comum nesta versão: o suporte à arquitetura kolibri1 ainda depende do launcher incluído nesse repositório comunitário. Conversões 4-bit podem alterar a qualidade das respostas.
Faça a primeira pergunta e repita offline (não testado por nós)
Com o download completo e o ambiente ativado, copie o comando inteiro:
python Kolibri-1-MLX-4bit/run.py generate --model Kolibri-1-MLX-4bit --prompt "Erkläre kurz den Unterschied zwischen Wetter und Klima." --chat-template-config '{"reasoning_effort": "low"}' --temp 1.0 --top-p 0.97 --top-k 128 --max-tokens 1024O prompt pede, em alemão, uma explicação curta da diferença entre tempo e clima. Não mostramos uma resposta inventada: confira o texto gerado na sua máquina. Depois desligue o Wi-Fi no macOS, confirme que não há conexão de rede e rode o mesmo comando. O modelo já baixado deve poder inferir localmente; se o launcher tentar buscar um arquivo, volte online, complete o download e repita. Abra o Monitor de Atividade, aba Memória, para conferir o uso real no seu Mac. Não temos medida própria de tokens/s ou de memória.
Para empresas: GPU própria (rota oficial; não testada por nós)
A Aleph Alpha documenta o pacote aleph-alpha-inference com o plugin de vLLM e API compatível com OpenAI. No servidor GPU adequado, instale e depois inicie o serviço:
python -m pip install "aleph-alpha-inference>=1.0"vllm serve Aleph-Alpha/Kolibri-1 --kv-cache-dtype fp8 --reasoning-parser kolibri1 --tool-call-parser kolibri1 --enable-auto-tool-choiceA imagem oficial alternativa é ghcr.io/aleph-alpha/aleph-alpha-inference. A Aleph Alpha recomenda temperatura 1.0, top_p 0.97 e top_k 128. O contexto nativo treinado é de 262.144 tokens; até 1.048.576 foi validado, mas a recomendação é ficar em até 262.144 para tarefas complexas e eficiência. Contexto grande exige ainda mais memória; não significa que o modelo nunca esquece.
Perguntas rápidas
É grátis? Em 08/10/2026, os pesos e a configuração estão disponíveis sob Apache 2.0 sem cobrança de licença. Máquina, energia e operação não são grátis. Não use um preço de computador sem conferir a loja na data de compra.
Fala português? Não como idioma-alvo declarado: o cartão oficial lista apenas inglês e alemão. A licença permite ajuste fino, mas isso não garante desempenho em português.
Funciona no Ollama ou no LM Studio? Não presuma. Em 08/10/2026, a rota documentada é vLLM com o plugin da Aleph Alpha ou MLX com launcher comunitário; não há aqui instalação de um clique validada nessas ferramentas.
Posso usar no meu produto? Sim, os pesos Apache 2.0 permitem uso comercial, respeitadas as condições da licença e as políticas de uso. Mantenha os dados internos apenas se você realmente servir localmente, sem encaminhar pedidos a terceiros.
A Aleph Alpha virou Cohere? Em 16/09/2026 as empresas anunciaram um acordo de fusão. Em 08/10/2026, a aprovação regulatória ainda estava pendente; não trate como concluída.
Fontes: modelo e licença, conversão MLX comunitária, lançamento e vLLM e acordo com Cohere.
Comentários
Ficou com alguma dúvida ou tem algo a acrescentar? Participe da conversa.
Sem precisar de conta. Clique em Entrar e escolha um nome para comentar.
Carregando a conversa…
Privacidade dos comentáriosDiretrizes para comentários