
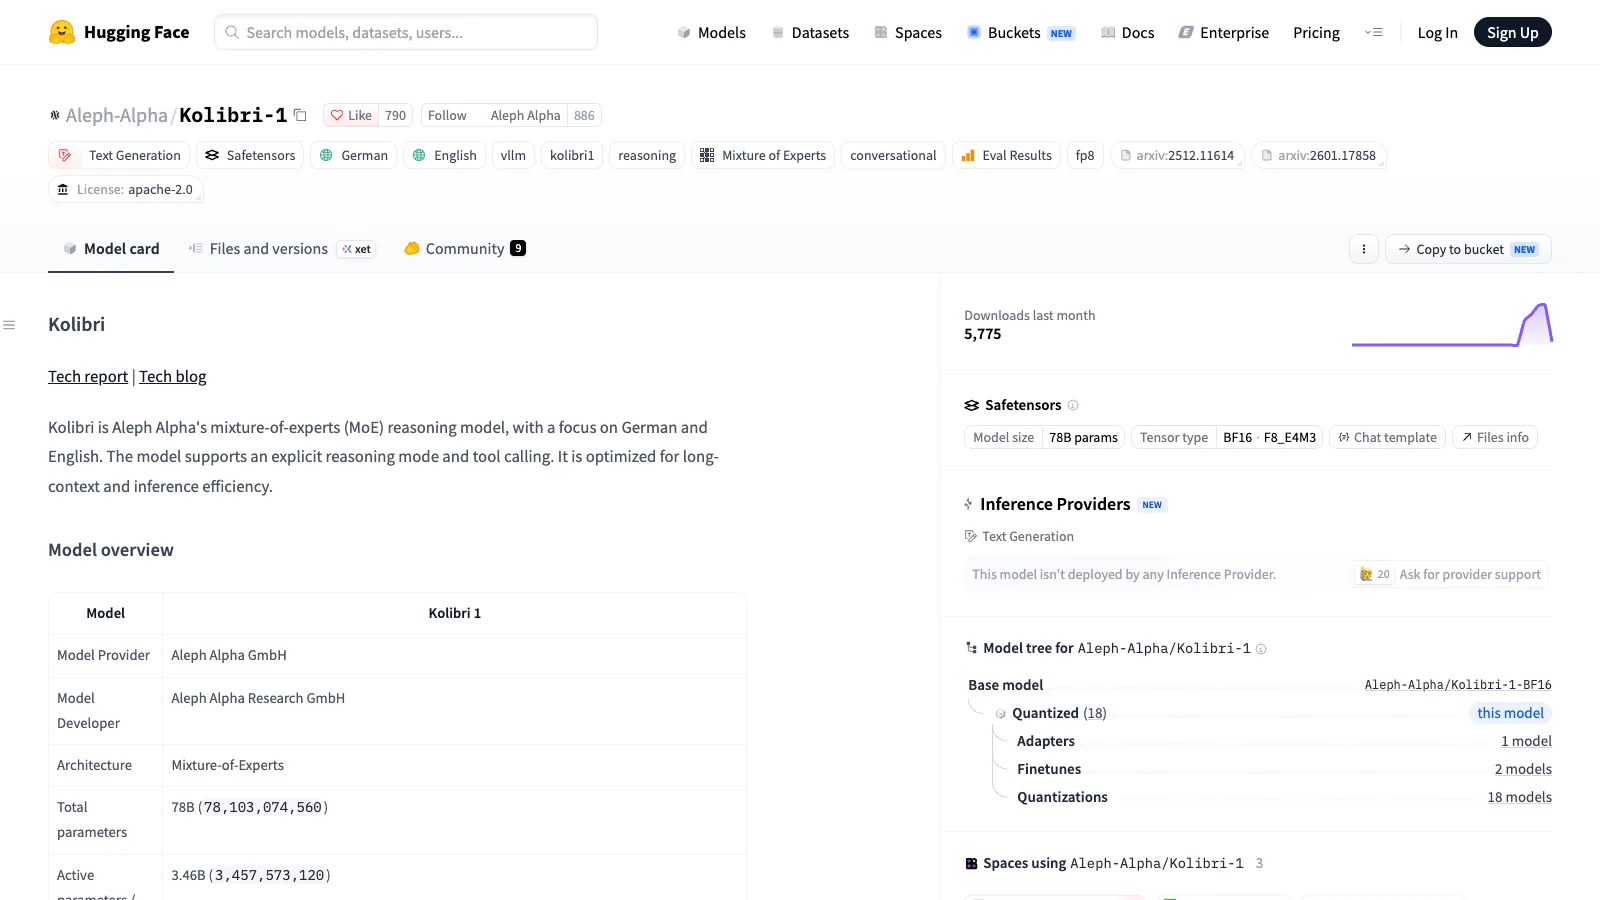
Kolibri-1 es un modelo de IA de texto de Aleph Alpha, empresa de Heidelberg, Alemania. Puedes descargar sus pesos de Hugging Face y alojarlo en tu propia infraestructura. Por ejemplo, un despacho puede analizar documentos sin enviarlos a un servicio externo. El alojamiento local no garantiza por sí solo el cumplimiento de las leyes de privacidad: sigue siendo necesario controlar accesos, conservación y seguridad.
Los pesos abiertos bajo Apache 2.0 permiten uso comercial y adaptación en un producto. La licencia cubre los pesos publicados y la configuración, no el código de entrenamiento. Salió el 03/10/2026. Es un modelo de texto para inglés y alemán, no un modelo en portugués ni uno de imágenes.
Imagina un hospital con 384 especialistas en cada planta: para cada palabra entran 6, además de 1 especialista compartido que siempre participa. Esta mezcla de expertos funciona en cada una de las 50 capas y para cada token. Hay 78.100 millones de parámetros en total, pero solo 3.460 millones activos por token. Aun así, todos los pesos tienen que caber en memoria.
¿Tienes el equipo necesario?
| Equipo | Opción al 08/10/2026 |
|---|---|
| Servidor GPU | Pesos FP8 oficiales: unos 78 GB. Mínimo 1 H200/B200/B300 o 2 A100 de 80 GB / H100 SXM5. |
| Mac Apple Silicon de 64 GB | Conversión MLX 4-bit no oficial, unos 41 GiB en disco; el autor reporta picos de 44 a 48 GB según el prompt. |
| Mac de 48 GB / 36 GB | Conversiones comunitarias de 3-bit / 2-bit respectivamente, con mayor pérdida de calidad. No son las de este tutorial. |
| Portátil normal / 16–32 GB | No esperes una inferencia local útil de este modelo. Elige uno más pequeño o un servidor. |
No hemos probado estos pasos en un Mac de 64 GB: nuestra máquina tiene 16 GB. No mostramos capturas de instalación, respuestas, Monitor de Actividad ni velocidades medidas por nosotros. Estos comandos proceden de la documentación de la conversión comunitaria y requieren una prueba manual en el equipo indicado.
Instala en un Mac de 64 GB (documentación, no probado por nosotros)
En un Mac Apple Silicon con 64 GB, Python 3 y más de 41 GiB libres, crea un entorno:
python3 -m venv kolibri-env && source kolibri-env/bin/activateInstala las dependencias y registra la versión. No hemos validado ninguna versión de mlx-lm; esto instala la disponible en el momento:
python -m pip install -U mlx-lm huggingface_hubpython -m pip show mlx-lmDescarga la conversión 4-bit de velaia con su lanzador. Revisa el código comunitario antes de ejecutarlo; no es una publicación oficial de Aleph Alpha:
hf download velaia/Kolibri-1-MLX-4bit --local-dir Kolibri-1-MLX-4bitNo presupongas que mlx_lm.generate reconoce kolibri1: hasta que exista soporte oficial en una versión publicada, esta conversión requiere su run.py y kolibri1.py. La cuantización puede reducir la calidad.
Haz una pregunta sin conexión (no probado por nosotros)
Después de descargar todo y activar el entorno, copia el comando completo:
python Kolibri-1-MLX-4bit/run.py generate --model Kolibri-1-MLX-4bit --prompt "Erkläre kurz den Unterschied zwischen Wetter und Klima." --chat-template-config '{"reasoning_effort": "low"}' --temp 1.0 --top-p 0.97 --top-k 128 --max-tokens 1024La pregunta en alemán pide explicar la diferencia entre tiempo y clima. Comprueba tú mismo la respuesta: no inventamos una salida. Apaga el Wi-Fi de macOS, confirma que no hay red y repite el mismo comando. Si faltan archivos, vuelve a conectarte para completar la descarga. En la pestaña Memoria del Monitor de Actividad podrás ver el consumo real. No hemos medido memoria ni tokens por segundo.
Para empresas: servidor GPU propio (vía oficial, no probada por nosotros)
Aleph Alpha documenta aleph-alpha-inference: instala su plugin de vLLM y expone una API compatible con OpenAI. En un servidor GPU adecuado:
python -m pip install "aleph-alpha-inference>=1.0"vllm serve Aleph-Alpha/Kolibri-1 --kv-cache-dtype fp8 --reasoning-parser kolibri1 --tool-call-parser kolibri1 --enable-auto-tool-choiceTambién existe el contenedor ghcr.io/aleph-alpha/aleph-alpha-inference. Muestreo recomendado: temperatura 1.0, top_p 0.97 y top_k 128. El contexto entrenado nativamente es de 262.144 tokens; se validaron hasta 1.048.576, pero Aleph Alpha recomienda como máximo 262.144 para tareas complejas y eficiencia. Una ventana grande no asegura recuerdo perfecto y consume más memoria.
Preguntas frecuentes
¿Es gratis? Al 08/10/2026, los pesos y la configuración están publicados bajo Apache 2.0 sin coste de licencia. Equipo, energía y operación cuestan dinero; consulta el precio actual antes de comprar.
¿Habla portugués? No como idioma objetivo declarado: la ficha oficial enumera inglés y alemán. La licencia permite ajustes, pero no garantiza calidad en portugués.
¿Funciona en Ollama o LM Studio? No lo presupongas. Al 08/10/2026, las vías documentadas son vLLM con el plugin de Aleph Alpha o MLX comunitario con su lanzador. No hemos validado una instalación con un clic en esas aplicaciones.
¿Puedo integrarlo en mi producto? Sí, Apache 2.0 permite uso comercial de los pesos, respetando sus condiciones y las pautas de uso responsable. Los datos solo quedan dentro si el despliegue realmente no envía prompts a terceros.
¿Se fusionó con Cohere? Anunciaron un acuerdo el 16/09/2026. Al 08/10/2026 todavía dependía de aprobación regulatoria; no afirmes que ya se cerró.
Fuentes: ficha oficial, conversión comunitaria, lanzamiento y comandos vLLM y acuerdo con Cohere.
Comentarios
¿Tienes alguna pregunta o algo que añadir? Participa en la conversación.
No necesitas una cuenta. Selecciona Entrar y elige un nombre para comentar.
Cargando la conversación…
Privacidad de los comentariosNormas para comentar